Panoramica del progetto

Settore: Trasporti

Portafoglio: Cloud e Data Center 

  • La sfida

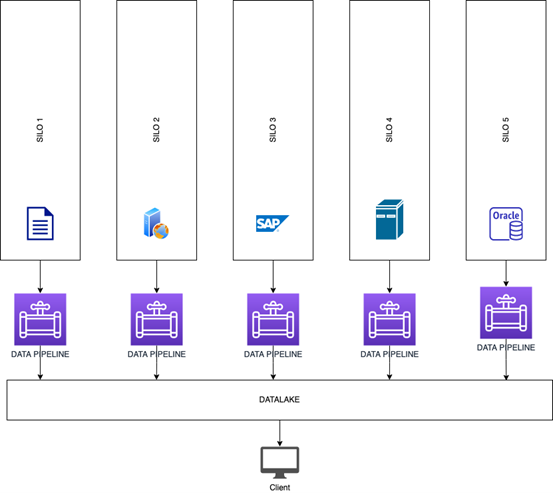
    Il problema dei silos

    Nelle aziende moderne, i dati sono onnipresenti e provengono da una vasta gamma di fonti diverse, quali:

    – Siti web aziendali

    – App aziendali

    – Dispositivi IoT

    – CRM

    – Social media

    – Strumenti di inventario e logistica (come SAP)

    – Data warehouse

    – Report interni

    – Canali di vendita

    – E chi più ne ha più ne metta

    Il problema principale di uno scenario del genere è che ciascuno di questi dati viene salvato in cosiddetti «silos verticali» e tali silos non sono progettati per consentire la condivisione dei dati tra di essi.

    Questo problema di fondo genera molte altre difficoltà:

    – cercare di analizzare quei dati con strumenti di aggregazione e trasversalmente tra i silos richiede un lavoro manuale noioso e soggetto a errori, che comporta esportazione di dati, estrazione di dati, «mambo-jambo» su fogli di calcolo: in pochi anni, le aziende si ritrovano con una serie di strumenti artigianali.

    – Tali strumenti artigianali sono piuttosto fragili e dipendono fortemente da chi li ha implementati originariamente, rendendone la manutenzione un incubo.

    – Quando si tratta di dati, non è chiaro quale sia la «unica fonte di verità».

    – È ancora meno chiaro dove risiedano i dati, specialmente nelle organizzazioni di medie e grandi dimensioni.

    – Spesso mancano i dati grezzi (non modificati).

  • La soluzione

    Il data lake 

    Un modo per risolvere il problema dei «silos verticali» è quello di costruire un data lake. Si tratta di un luogo in cui i dati, provenienti da diverse fonti, possono essere archiviati e consultati in modo coerente. I dati vengono archiviati nel loro formato naturale/grezzo, rendendo possibile la loro futura manipolazione. A volte nel data lake vengono archiviati anche dati trasformati; questi sono necessari per attività quali la reportistica, la visualizzazione, l’analisi avanzata e l’apprendimento automatico.

    Di solito la «linea di discendenza» dei dati (da dove provengono, quando sono stati acquisiti e manipolati e da chi/cosa) viene salvata insieme ai set di dati (come metadati o utilizzando un metodo di ricerca semplice).

    Che cos’è una pipeline di dati? 

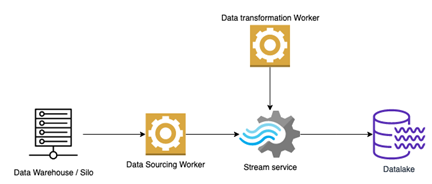
    Per «alimentare» un data lake, è necessario predisporre dei worker che acquisiscano i dati dalle fonti (silos). Ogni worker è specifico per una fonte di dati ed è collegato a servizi che consentono un’ulteriore analisi dei dati quasi in tempo reale. Questo insieme di funzionalità (worker + servizi) è comunemente indicato come «data pipeline». Per analogia con le pompe e le tubature dell’acqua, i dati vengono estratti («pompati») dalle fonti e «scorrono» attraverso i servizi fino a quando non approdano nei data lake o in specifiche soluzioni di archiviazione/database.

  • Passare al serverless

    La creazione di un data lake e l’alimentazione delle data pipeline possono essere realizzate utilizzando:

    a) Servizi on-premise
    b) Serviziautogestiti basati sul cloud
    c) Servizi cloud completamente gestiti
    d) Infrastruttura serverless basata su cloud

    Il livello di impegno richiesto per gestire le architetture precedenti diminuisce significativamente da a) a d).

    Nel caso a), tutto il lavoro operativo ricade sul team IT, compresa la gestione dell’hardware.
    Nel caso d), le uniche cose su cui il team IT deve concentrarsi sono:

    – sviluppo della logica applicativa (logica dei worker);

    – l’utilizzo degli strumenti giusti per il lavoro e delle relative API, seguendo le migliori pratiche di sicurezza.

    Poiché i data lake comportano molte parti in movimento e tecnologie diverse, passare a un modello completamente serverless è una scelta che vale la pena prendere in considerazione per ridurre la complessità operativa.

    I servizi utilizzati in questa implementazione sono:

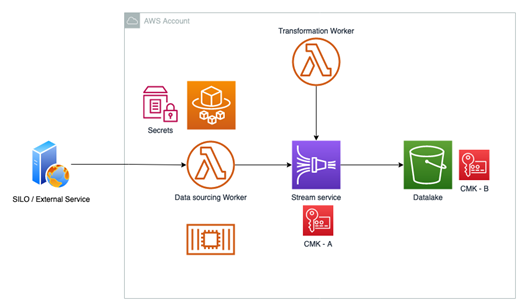
    AWS Lambda come infrastruttura di calcolo per l’esecuzione dei worker di acquisizione dati e dei worker di trasformazione

    AWS Kinesis Stream / Firehose come fornitore di servizi di streaming dati

    Amazon S3 come sistema di archiviazione del data lake

    AWS KMS come servizio di crittografia

    AWS System Manager Parameter Store come repository per i segreti

    AWS IAM per la definizione di policy e ruoli

    Esaminiamo brevemente ciascun componente per analizzare la logica alla base delle scelte architetturali.

    Data Sourcing Worker => AWS Lambda:

    Questo worker deve connettersi al silo/servizio ed estrarre i dati da esso. A seconda del tipo di dati e del loro utilizzo, questo worker potrebbe essere eseguito poche volte al giorno o in modo continuo. In un ambiente serverless su AWS, le opzioni sono:

    Lambda (esecuzione pianificata)

    Un container distribuito su ECS utilizzando Fargate come infrastruttura di calcolo (esecuzione continua)

    Abbiamo optato per Lambda perché il cliente desiderava un’architettura di pipeline di dati in grado di gestire diverse frequenze di dati; per flussi di dati quasi continui, una frequenza di invocazione breve abbinata a piccoli set di dati per esecuzione offre una buona soluzione per utilizzare una semplice funzione Lambda invece di un worker containerizzato più complicato, mantenendo anche la coerenza architettonica con flussi di dati discreti.

    Worker di trasformazione => AWS Lambda:

    Questo worker trasforma i dati in base a criteri specifici, che dipendono dall’effettiva fonte dei dati. Lambda è la soluzione consigliata da utilizzare insieme ad AWS Kinesis Firehose. Un evento di input viene generato da Kinesis con dati grezzi provenienti dalla fonte, Lambda elabora e trasforma i dati secondo la logica implementata dal codice e i dati trasformati vengono rispediti a Kinesis Firehose affinché possano essere conservati.

    Servizio di streaming => Kinesis Stream / Firehose:

    Gli stream sono particolarmente utili nell’acquisizione dei dati perché bufferizzano i dati in ingresso per un periodo configurabile e consentono a un’architettura pluggable di consumare, analizzare ed elaborare i dati, in batch e/o quasi in tempo reale. Kinesis Firehose è un servizio di stream di dati gestito serverless, il cui scopo è scaricare dati in modo continuo verso un tipo di destinazione specifico. In questo caso specifico, la destinazione è un bucket S3. Come Kinesis Stream, Firehose può generare eventi allegando i dati che vi scorrono. Tali eventi possono essere utilizzati per eseguire codice tramite Lambda o per attivare attività complesse utilizzando AWS Step-Functions o altri servizi AWS.

    Data lake => Amazon S3:

    Capacità di archiviazione illimitata, criteri di ciclo di vita configurabili e metadati personalizzati sono perfetti per creare un data lake. Amazon S3 offre tutto questo, insieme a una potente API e a una perfetta integrazione con altri servizi AWS, come Firehose. Il data lake può consistere in un singolo bucket o in più bucket (dati grezzi, dati trasformati, dati aggregati…)

    Sicurezza 1 => KMS:

    I dati in transito e inattivi vengono crittografati utilizzando KMS con CMK (Customer Master Keys) a ambito limitato

    Sicurezza 2 => Ruolo e politiche specifici per Lambda:

    Le funzioni Lambda vengono eseguite utilizzando autorizzazioni con ambito ridotto, espresse tramite documenti di policy IAM associati a un ruolo specifico assegnato alla funzione Lambda.

    Sicurezza 3 => Segreti:

    Per archiviare i segreti e i parametri a livello di servizio, viene utilizzato Parameter Store. I segreti vengono salvati come stringhe sicure e crittografati con KMS utilizzando una CMK dedicata

  • Implementazione

    AWS offre un’ampia scelta, quindi esistono servizi per costruire ciascuna delle architetture menzionate in precedenza. I clienti possono passare da un’infrastruttura completamente on-premise (noleggiando macchine bare metal) a un’infrastruttura completamente serverless e event-driven. E anche in uno scenario serverless ci sono diverse opzioni tra cui scegliere.


Risultati e vantaggi

Vantaggio 1 

Una delle caratteristiche principali di questa implementazione è la sua modularità: una volta descritta utilizzando alcuni strumenti IaC (come CloudFormation o, come nel nostro caso, Terraform), può essere facilmente modellata e riprodotta per ogni altra pipeline di dati e in diversi ambienti, poiché l’unica differenza tra le pipeline è il codice in Lambda e i suoi parametri di esecuzione.

Vantaggio 2 

La standardizzazione dell’architettura con i modelli aiuta enormemente nel failover multiregione.

Vantaggio 3 

L’utilizzo di servizi serverless e stateless completamente disaccoppiati li rende inoltre scalabili fin da subito.

Conclusione 

I data lake sono fondamentali per liberare i dati e renderli disponibili a più utenti e strumenti standard.

Sono anche piuttosto impegnativi da implementare correttamente da zero, poiché richiedono competenze nel cloud e buone capacità di sviluppo. Avere il partner giusto in questa fase aiuta e accelera notevolmente il processo. I principali fornitori di servizi cloud come AWS offrono un’ampia gamma di strumenti e servizi per rendere la transizione dai silos di dati all’ubiquità dei dati molto più semplice e sostenibile dal punto di vista operativo nel lungo termine. Lo abbiamo dimostrato con il nostro cliente, dove un team di dimensioni ridotte, operante interamente da remoto, ha sviluppato e implementato in produzione diverse data pipeline, rendendo i dati ampiamente accessibili alle unità aziendali e operative. Nel 2021 ci sono meno scuse per non introdurre i data lake e l’acquisizione automatizzata dei dati tramite data pipeline nella strategia aziendale sui dati.

SBB Cargo AG

FSS Cargo è una filiale delle Ferrovie Federali Svizzere (FFS) specializzata nel trasporto merci su rotaia e opera come divisione Merci. La sede centrale di SBB Cargo AG, denominazione ufficiale della divisione Merci delle Ferrovie Federali Svizzere, si trova a Olten. Nel 2013, SBB Cargo contava 3’061 collaboratori e ha realizzato un fatturato consolidato di 953 milioni di franchi. [1] In Svizzera, SBB Cargo è leader di mercato nel trasporto merci su rotaia, trasportando ogni giorno oltre 175’000 tonnellate di merci. Ciò corrisponde al peso di 425 jumbo jet a pieno carico.


Partner tecnologico

Axians Logo in einer Fensterscheibe