
Project Overview
Secteur : Transport
Portefeuille : Cloud et centre de données
-
Le défi
Le défi
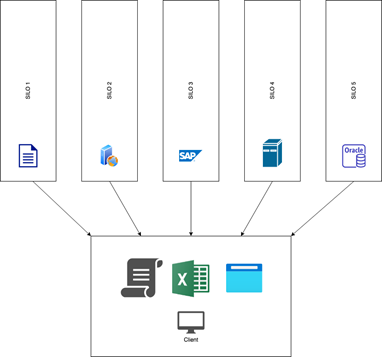
Le problème des silos
Dans les entreprises modernes, les données sont omniprésentes et proviennent d’un large éventail de sources différentes, telles que :
– Site(s) web de l’entreprise
– Applications de l’entreprise
– Les appareils IoT
– Les CRM
– Réseaux sociaux
– Outils de gestion des stocks et de logistique (comme SAP)
– Entrepôts de données
– Rapports internes
– Canaux de vente
– Etc.
Le principal problème d’un tel scénario est que chacune de ces données est stockée dans ce qu’on appelle des « silos verticaux », et ces silos ne sont pas conçus pour permettre le partage de données entre eux.
Ce problème fondamental engendre de nombreuses autres difficultés :
– tenter d’analyser ces données à l’aide d’outils d’agrégation et de manière transversale entre les silos nécessite un travail manuel fastidieux et source d’erreurs, impliquant l’exportation de données, l’extraction de données et des « bidouillages » dans des tableurs : en quelques années, les entreprises se retrouvent avec un ensemble d’outils artisanaux.
– Ces outils artisanaux sont assez fragiles et dépendent fortement de la personne qui les a initialement mis en place, ce qui rend leur maintenance cauchemardesque.
– En matière de données, il est difficile de déterminer quelle est la « source unique de vérité ».
– L’emplacement des données est encore plus difficile à déterminer, en particulier dans les moyennes et grandes entreprises.
– Les données brutes (non modifiées) font souvent défaut.

-
La solution
Le lac de données
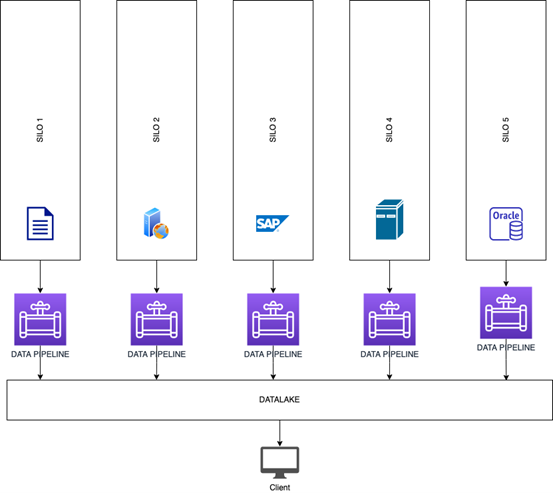
Une façon de résoudre le problème des « silos verticaux » consiste à créer un lac de données. Il s’agit d’un espace où les données, provenant de différentes sources, peuvent être stockées et consultées de manière cohérente. Les données sont stockées dans leur format naturel/brut, ce qui permet leur manipulation ultérieure. Parfois, des données transformées sont également stockées dans le lac de données ; elles sont nécessaires pour des tâches telles que le reporting, la visualisation, l’analyse avancée et l’apprentissage automatique.
En général, la « traçabilité » des données (d’où elles proviennent, quand elles ont été acquises et manipulées, et par qui ou quoi) est enregistrée avec les ensembles de données (sous forme de métadonnées ou via un système de recherche simple).
Qu’est-ce qu’un pipeline de données ?
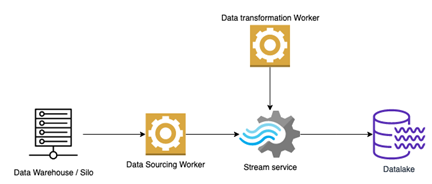
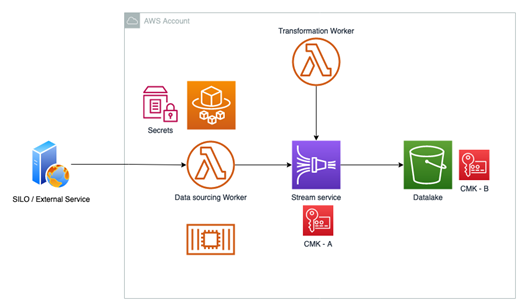
Pour « alimenter » un lac de données, il faut mettre en place des « workers » qui acquièrent les données à partir de sources (silos). Chaque agent est dédié à une source de données et est relié à des services permettant une analyse des données en temps quasi réel. Cet ensemble de fonctionnalités (agent + services) est communément appelé « pipeline de données ». À l’instar des pompes à eau et des canalisations, les données sont extraites (« pompées ») des sources et « circulent » à travers les services jusqu’à ce qu’elles aboutissent dans des lacs de données ou des solutions de stockage/bases de données spécifiques.


-
Passer au sans serveur
-
Mise en œuvre
AWS est une plateforme qui offre de nombreuses possibilités, il existe donc des services permettant de construire chacune des architectures mentionnées précédemment. Les clients peuvent passer d’une infrastructure entièrement sur site (location de machines bare metal) à une infrastructure entièrement sans serveur et pilotée par les événements. Et même dans un scénario sans serveur, plusieurs options s’offrent à eux.

Résultats et avantages
Avantage 1
L’une des principales caractéristiques de cette implémentation est sa modularité : une fois décrite à l’aide d’outils IaC (tels que CloudFormation ou, comme dans notre cas, Terraform), elle peut être facilement modélisée et reproduite pour n’importe quel autre pipeline de données et dans différents environnements, car la seule différence entre les pipelines réside dans le code Lambda et ses paramètres d’exécution.
Avantage 2
La standardisation de l’architecture à l’aide de modèles facilite considérablement le basculement multirégional.
Avantage 3
L’utilisation de services sans serveur et sans état entièrement découplés les rend également évolutifs dès le départ.
Conclusion
Les lacs de données sont essentiels pour libérer les données et les rendre accessibles à davantage d’utilisateurs et d’outils standard.
Ils sont également assez complexes à mettre en œuvre correctement à partir de zéro, car ils nécessitent des compétences en cloud et de bonnes capacités de développement. Avoir le bon partenaire à ce stade facilite et accélère considérablement le processus. Les principaux fournisseurs de services cloud tels qu’AWS proposent une large gamme d’outils et de services pour rendre la transition des silos de données vers l’ubiquité des données beaucoup plus simple et viable sur le plan opérationnel à long terme. Nous l’avons démontré avec notre client, où une petite équipe, travaillant entièrement à distance, a développé et mis en production plusieurs pipelines de données, rendant ainsi les données largement accessibles aux unités commerciales et opérationnelles. En 2021, il y a moins d’excuses pour ne pas intégrer les lacs de données et l’acquisition automatisée des données via des pipelines de données dans la stratégie de données de l’entreprise.
SBB Cargo AG

CFF Cargo est une filiale des Chemins de fer fédéraux suisses (CFF) spécialisée dans le fret ferroviaire et opérant sous le nom de division Fret. Le siège social de SBB Cargo AG, la dénomination officielle de la division Fret, se trouve à Olten. En 2013, SBB Cargo comptait 3 061 employés et a réalisé un chiffre d’affaires consolidé de 953 millions de francs suisses.[1] En Suisse, SBB Cargo est le leader du marché du fret ferroviaire, transportant plus de 175 000 tonnes de marchandises chaque jour. Cela correspond au poids de 425 gros-porteurs à pleine charge.
Partenaires technologiques

