
Project Overview
Branche: Transport
Portfolio: Cloud und Rechenzentrum
-
Ausgangslage
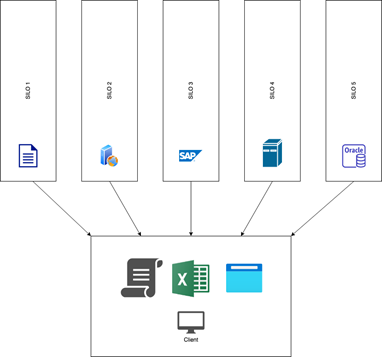
Das Silo-Problem
In modernen Unternehmen sind Daten allgegenwärtig und stammen aus einer Vielzahl unterschiedlicher Quellen, wie zum Beispiel:
– Unternehmenswebsite(s)
– Unternehmens-App(s)
– IoT-Geräte
– CRMs
– Soziale Medien
– Bestands- und Logistiktools (wie SAP)
– Data Warehouses
– Interne Berichte
– Vertriebskanäle
Was auch immer
Das Hauptproblem eines solchen Szenarios besteht darin, dass jede dieser Daten in sogenannten „vertikalen Silos“ gespeichert wird und diese Silos nicht für den datenübergreifenden Austausch ausgelegt sind.
Dieses Grundproblem führt zu vielen weiteren Schwierigkeiten:
– Der Versuch, diese Daten mit Aggregationstools und siloübergreifend zu analysieren, erfordert viel fehleranfällige und mühsame Handarbeit, einschliesslich Datenexport, Datenextraktion und Tabellenkalkulations-„Mambo-Jambos“: Innerhalb weniger Jahre verfügen Unternehmen schliesslich über eine Reihe von handgefertigten Tools.
– Solche selbst entwickelten Tools sind sehr anfällig und stark von der Person abhängig, die sie ursprünglich implementiert hat, was ihre Wartung zu einem Albtraum macht.
– Wenn es um Daten geht, ist unklar, was die „einzige Quelle der Wahrheit“ ist.
– Noch unklarer ist, wo sich die Daten befinden, insbesondere in mittelgrossen bis grossen Unternehmen.
– Rohdaten (unbearbeitete Daten) fehlen oft.

-
Lösungen
Der Data Lake
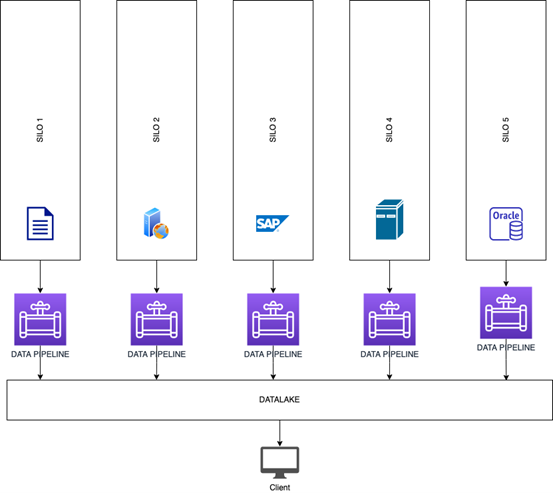
Eine Möglichkeit, das Problem der „vertikalen Silos“ zu lösen, ist der Aufbau eines Data Lake. Dies ist ein Ort, an dem Daten aus verschiedenen Quellen auf einheitliche Weise gespeichert und abgerufen werden können. Die Daten werden in ihrem natürlichen/Rohformat gespeichert, was eine spätere Datenbearbeitung ermöglicht. Manchmal werden auch transformierte Daten im Data Lake gespeichert; diese sind für Aufgaben wie Berichterstellung, Visualisierung, erweiterte Analysen und maschinelles Lernen erforderlich.
In der Regel wird die „Herkunft“ der Daten (woher die Daten stammen, wann sie erfasst und bearbeitet wurden und von wem/was) zusammen mit den Datensätzen gespeichert (als Metadaten oder auf eine leicht durchsuchbare Weise).
Was ist eine Datenpipeline?
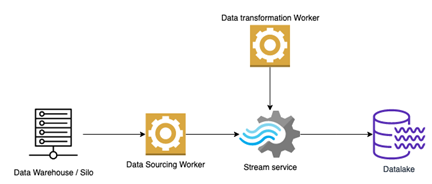
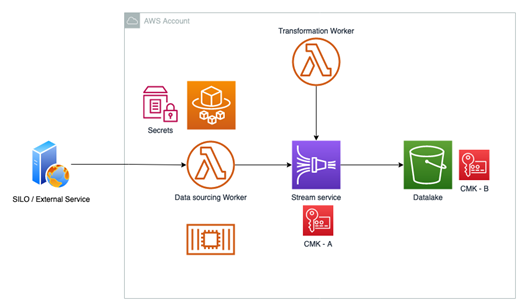
Um einen Data Lake zu „befüllen“, müssen Worker bereitgestellt werden, die Daten aus Quellen (Silos) erfassen. Jeder Worker ist für eine bestimmte Datenquelle zuständig und mit Diensten verbunden, die eine weitere Datenanalyse nahezu in Echtzeit ermöglichen. Diese Kombination aus Funktionen (Worker + Dienste) wird gemeinhin als „Datenpipelines“ bezeichnet. Analog zu Wasserpumpen und -rohren werden Daten aus Quellen extrahiert („gepumpt“) und „fliessen“ durch Dienste, bis sie in Data Lakes oder spezifischen Speicher-/Datenbanklösungen landen.


-
Umstieg auf serverlose Lösungen
-
Umsetzung
Bei AWS dreht sich alles um Auswahlmöglichkeiten, daher gibt es Dienste, mit denen sich jede der zuvor genannten Architekturen aufbauen lässt. Kunden können von einer vollständig lokalen Lösung (Miete von Bare-Metal-Maschinen) bis hin zu einer vollständig serverlosen, ereignisgesteuerten Infrastruktur wechseln. Und selbst in einem serverlosen Szenario stehen mehrere Optionen zur Auswahl.

Resultate & Mehrwert
Vorteil 1
Eines der Hauptmerkmale dieser Implementierung ist ihre Modularität: Sobald sie mithilfe einiger IaC-Tools (wie CloudFormation oder, wie in unserem Fall, Terraform) beschrieben wurde, lässt sie sich leicht als Vorlage speichern und für jede andere Datenpipeline sowie in verschiedenen Umgebungen reproduzieren, da der einzige Unterschied zwischen den Pipelines der Code in den Lambdas und deren Ausführungsparameter ist.
Vorteil 2
Die Standardisierung der Architektur mithilfe von Vorlagen ist eine enorme Hilfe beim Failover über mehrere Regionen hinweg.
Vorteil 3
Durch den Einsatz serverloser und vollständig entkoppelter zustandsloser Dienste sind diese zudem von Haus aus skalierbar.
Fazit
Data Lakes sind der Schlüssel, um Daten freizusetzen und sie für mehrere Nutzer und Standardtools verfügbar zu machen.
Ihre korrekte Implementierung von Grund auf ist jedoch eine grosse Herausforderung, da sie Cloud-Expertise und gute Entwicklungskompetenzen erfordern. Der richtige Partner in dieser Phase ist eine grosse Hilfe und beschleunigt den Prozess erheblich. Grosse Cloud-Anbieter wie AWS stellen eine riesige Auswahl an Tools und Diensten bereit, um den Übergang von Datensilos zu Datenallgegenwart wesentlich zu vereinfachen und langfristig betrieblich nachhaltig zu gestalten. Das haben wir bei unserem Kunden bewiesen, wo ein vollständig remote arbeitendes, kleines Team mehrere Datenpipelines entwickelte und in die Produktion überführte, wodurch Daten für Geschäfts- und Betriebseinheiten breit zugänglich gemacht wurden. Im Jahr 2021 gibt es kaum noch Ausreden, Data Lakes und die automatisierte Datenerfassung über Datenpipelines nicht in die Unternehmensdatenstrategie aufzunehmen.
SBB Cargo AG

SBB Cargo ist eine Tochtergesellschaft der Schweizerischen Bundesbahnen (SBB), die sich auf den Schienengüterverkehr spezialisiert hat und als Güterverkehrssparte geführt wird. Der Hauptsitz der SBB Cargo AG, der offiziellen Bezeichnung der Güterverkehrssparte, befindet sich in Olten. Im Jahr 2013 beschäftigte SBB Cargo 3.061 Mitarbeiter und erzielte einen konsolidierten Umsatz von 953 Millionen CHF.[1] In der Schweiz ist SBB Cargo Marktführer im Schienengüterverkehr und transportiert täglich über 175’000 Tonnen Güter. Dies entspricht dem Gewicht von 425 voll beladenen Jumbojets.
Technologie-Partner

